练习 1 – 线程创建与优先级
线程创建与优先级
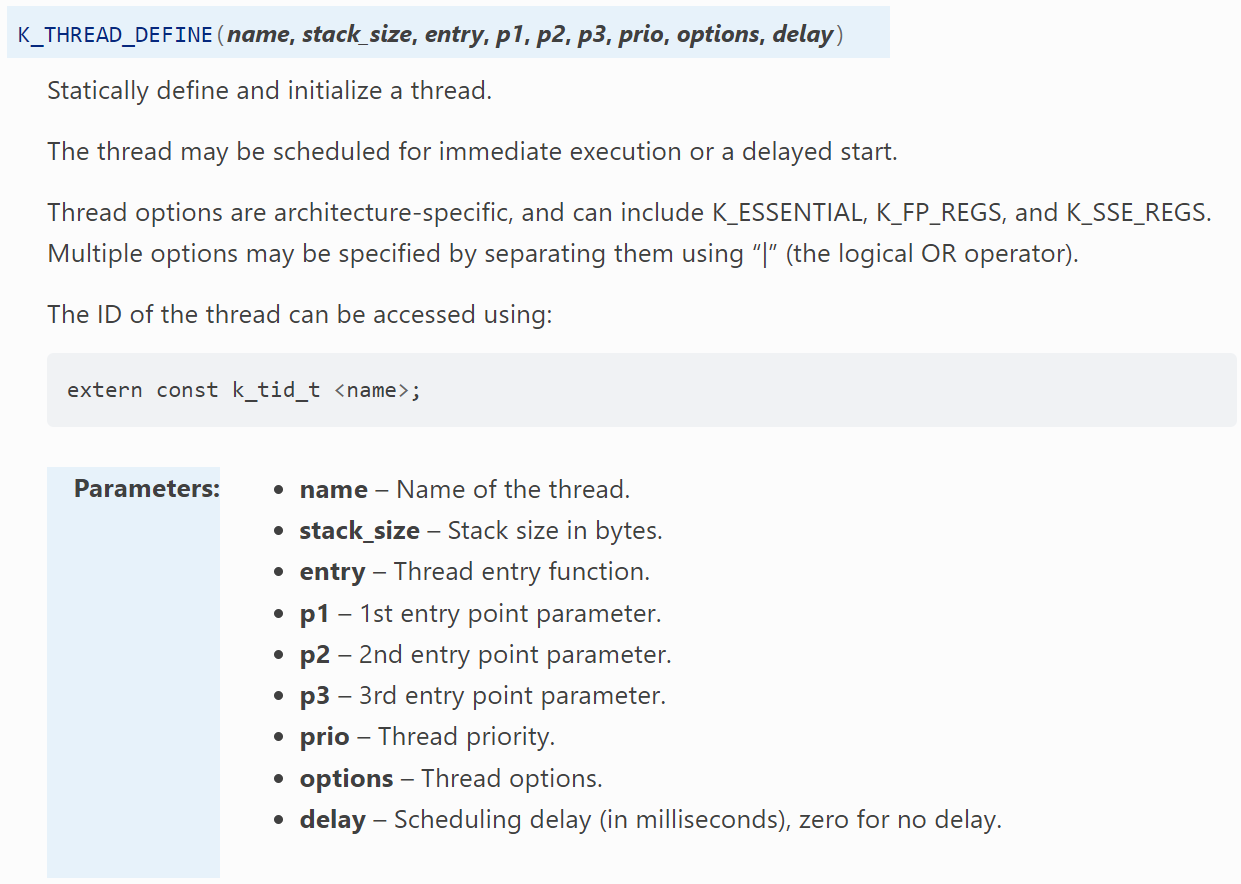
在本练习中,我们将学习如何创建和初始化两个线程,并了解它们的优先级如何相互影响。在 Zephyr 中有两种创建线程的方法,第一种是通过动态方式(在运行时)使用 k_thread_create() 而另一种更常用的方法是使用 K_THREAD_DEFINE() 宏以静态方式(在编译时)创建。这是用于定义和初始化线程并将其数据结构插入 RTOS 内核的宏,其 API 如下所示:
K_THREAD_DEFINE API练习步骤
1. 在本课程的 GitHub 仓库中,打开此练习的基础代码,位于 l7/l7_e1。
创建并初始化线程
2. 在定义这两个线程时,指定它们的栈大小以及调度优先级。
#define STACKSIZE 1024
#define THREAD0_PRIORITY 7
#define THREAD1_PRIORITY 7尽管本练习中的线程很简单,但我们仍将堆栈大小设置为 1024。堆栈大小应始终为 2 的幂次(512、1024、2048 等)。
注意
在实际应用开发中,您应该更仔细地选择堆栈大小,以避免不必要的堆栈空间占用。对于这个简单的应用程序,我们不需要那样做。
我们为这两个线程赋予相同的优先级。在这种情况下,使用的具体数值并不重要。
3. 已为您提供了这两个线程的线程入口函数(thread0 和 thread1),但它们不包含任何代码。现在,让我们让它们执行一些非常简单的操作,即在 while 循环中打印一个字符串。
在 thread0 和 thread1 入口函数中添加以下 printk() 语句。请务必将第二个线程的名称更改为 thread1。
printk("Hello, I am thread0\n");由于线程之间没有依赖关系,既不让出也不睡眠,因此它们将始终处于“可运行”状态,竞争 CPU 资源。
4. 现在我们已经定义了必要的参数,可以使用 K_THREAD_DEFINE() 来定义这两个线程 thread0 和 thread1,。传递要创建的线程名称、其堆栈大小、线程入口函数、启动时传递给线程的可选参数(最多三个)、线程优先级、可选的线程选项,以及最后的可选调度延迟。
对于传递给线程的可选参数,我们将传递 NULL。
对于可选的线程选项,它可以允许我们进行配置,例如,是否将线程视为基本线程 K_ESSENTIAL。它指示内核将线程的终止或中止视为致命系统错误。默认情况下,线程不被视为基本线程。在本练习中,我们将不设置任何选项。
对于可选的调度延迟,我们也将其设置为零,这代表线程创建完成后,立即进入就绪态。
K_THREAD_DEFINE(thread0_id, STACKSIZE, thread0, NULL, NULL, NULL,
		THREAD0_PRIORITY, 0, 0);
K_THREAD_DEFINE(thread1_id, STACKSIZE, thread1, NULL, NULL, NULL,
THREAD1_PRIORITY, 0, 0);线程名称可以任意指定,但它会被用作线程 ID,因此命名要慎重。
5. 构建应用程序并将其烧录到您的开发套件中。使用串口终端,您应该看到以下输出:
*** Booting nRF Connect SDK ***
Hello, I am thread0
Hello, I am thread0
Hello, I am thread0
Hello, I am thread0
Hello, I am thread0
Hello, I am thread0
Hello, I am thread0
Hello, I am thread0
Hello, I am thread0
Hello, I am thread0
Hello, I am thread0
Hello, I am thread0
Hello, I am thread0
Hello, I am thread0
Hello, I am thread0
Hello, I am thread0请注意,我们只看到来自 thread0 的输出,这表明 thread1 从未得到运行,即使两个线程都是使用相同的参数和优先级创建的。第二个线程正处于饥饿状态,这意味着它一直被阻塞,因为 thread0 从不让出、等待(睡眠)或执行任何其他触发重调度点的事件。
让我们看看如何解决这个问题。
线程让出
为了避免 thread1 饥饿,我们让 thread0 调用 k_yield() 主动让出。
k_yield() 会导致当前线程将执行权让给(yield)另一个具有相同或更高优先级的线程。该线程将处于“可运行”状态,只是被推到了“可运行”线程列表的末尾。如果该列表中没有其他相同或更高优先级的线程,则该线程会立即再次运行。
注意
为了给较低优先级的线程运行机会,当前线程需要被置于“不可运行”状态。这可以使用 k_sleep() 来实现,我们将在本练习的后续部分看到。
线程通常在两种场景下主动让出 CPU:没有后续任务要执行,或是希望给其他同优先级、更高优先级线程运行机会。调用 k_yield() 一般是有业务逻辑考量的。 为简化本次实验,我们让 thread0 每次打印完 printk() 信息之后就执行让出操作。
6. 更改 thread0 的入口函数,使其在运行 printk() 后让出。
k_yield();7. 构建应用程序并将其烧录到您的开发套件中。使用串口终端,您现在应该看到以下输出:
*** Booting nRF Connect SDK ***
Hello, I am thread0
Hello, I am thread1
Hello, I am thread1
Hello, I am thread1
Hello, I am thread1
Hello, I am thread1
Hello, I am thread1
Hello, I am thread1
Hello, I am thread1
Hello, I am thread1
Hello, I am thread1
Hello, I am thread1
Hello, I am thread1
Hello, I am thread1
Hello, I am thread1
Hello, I am thread1可以看到,thread0 现在打印一条信息后就主动让出 CPU 给同优先级或更高优先级线程。此时有另一个处于就绪态的同优先级线程,调度器会把它切换为运行态,分配 CPU 时间。而 thread1 不会主动让出 CPU,所以它一旦开始运行就会一直占用 CPU,造成 thread0 线程饥饿。
8. 在 thread1 的打印语句后增加 k_yield(),让 thread1 也主动让出 CPU。
k_yield();9. 构建应用程序并将其烧录到您的开发套件中。使用串口终端,您现在应该看到以下输出:
*** Booting nRF Connect SDK ***
Hello, I am thread0
Hello, I am thread1
Hello, I am thread0
Hello, I am thread1
Hello, I am thread0
Hello, I am thread1
Hello, I am thread0
Hello, I am thread1
Hello, I am thread0
Hello, I am thread1
Hello, I am thread0
Hello, I am thread1
Hello, I am thread0
Hello, I am thread1CPU 上的事件看起来与下面的类似

现在两个线程打印完信息后都会主动让出 CPU,调度器会在每次线程让出时介入,检查就绪队列里是否存在可运行线程。由于两个线程优先级相同,调度器总会选择另一个线程作为下一个运行线程,最终实现两个线程交替执行。
这种方式的缺点是:频繁让出 CPU、反复触发调度器本身也会消耗 CPU 资源。每次调用 k_yield(),调度器都要花费 CPU 时间维护内核资源的管理信息,这同时也会增加功耗。 架构设计良好的系统,会合理规划线程,让调度器的 CPU 开销尽可能小:也就是给线程设置合适的优先级,并且让线程合理配合其他线程(主动让出、休眠或等待资源)。
线程睡眠
打印并不是重要的任务,所以我们的线程降低打印频率是可以接受的。因此更好的方案是让线程休眠,而不是主动让出 CPU。 线程进入休眠后会切换到非就绪态,几乎不消耗算力。这可以通过 k_sleep() 或者它的衍生函数实现,例如 k_msleep()。
注意
k_sleep() 需要一个 k_timeout_t 类型的参数,可以使用如下宏来构造: K_MSEC(). 为了简单起见,k_sleep() 具有更易于使用的派生函数,如 k_msleep() 和 k_usleep() ,您可以直接传递时间数值。后者将被广泛使用。
10. 让我们尝试一下,将两个线程中的 k_yield() 函数替换为 k_msleep(5),即 5 毫秒的睡眠时间。修改后的线程代码如下:
void thread0(void)
{
	while (1) {
           printk("Hello, I am thread0\n");
           k_msleep(5);
	}
}

void thread1(void)
{
	while (1) {
           printk("Hello, I am thread1\n");
	         k_msleep(5);
	}
}11. 构建应用程序并将其烧录到您的开发套件中。使用串口终端,您现在应该看到以下输出:
*** Booting nRF Connect SDK ***
Hello, I am thread0
Hello, I am thread1
Hello, I am thread0
Hello, I am thread1
Hello, I am thread0
Hello, I am thread1
Hello, I am thread0
Hello, I am thread1
Hello, I am thread0
Hello, I am thread1
Hello, I am thread0
Hello, I am thread1
Hello, I am thread0
Hello, I am thread1虽然打印输出看起来和之前调用 k_yield() 时几乎一样,但二者存在本质区别。使用休眠后线程的打印频率更低,调度器被触发的次数也更少。请看下方时序图,留意空闲时段 —— 系统在这段时间可以进入低功耗状态。

如您所见,当两个线程都休眠一段时间,并且调度器没有其他就绪线程可以调度运行时,空闲线程(属于系统线程之一)就会被调度投入运行。
结论:
k_yield()会把线程状态从运行态切换为就绪态。也就是说,在下一次重调度点,刚刚让出 CPU 的这个线程仍然是调度器候选对象,有机会被选为运行态线程。最终效果:线程执行 yield 之后,就绪队列里至少还有这一个线程可供调度器选择。k_sleep()会把线程状态从运行态切换为非就绪态;等到超时时间到达,才会转为就绪态。这意味着在超时时间结束之前,该线程不会进入调度候选队列。 因此,如果是要实现延时,优先使用线程休眠,而不是 yield。
此练习的解决方案可以在 GitHub 仓库的 l7/l7_e1_sol 中找到。